TL;DR:
Dieser Artikel bietet einen konzeptionellen Vergleich zwischen dem „Remoteproc Load Model“ und dem „Attach Model“ für heterogene Multi-Core-SoCs (z. B. ARM Cortex-A mit Linux + Cortex-M mit Zephyr-RTOS). Er erläutert, wie der RTOS-Start aus dem kritischen Boot-Pfad von Linux herausgelagert werden kann, um Startverzögerungen im Millisekundenbereich zu erreichen, und beschreibt detailliert den zugrunde liegenden Kommunikationsstack zwischen den Prozessoren (Shared Memory, Resource Table, VirtIO/VRings, RPMsg).
Kernproblem: Das standardmäßige Linux-Remoteproc-Load-Modell startet den Echtzeit-Kern aus dem Linux-Userspace heraus, was zu Startverzögerungen von mehreren Sekunden führt, die für Hard-Echtzeit- oder Sicherheitsanwendungen inakzeptabel sind.
Vorgeschlagene Lösung: Das „Attach“-Modell, bei dem der Bootloader das RTOS (z. B. Zephyr) innerhalb von Millisekunden vor dem Start von Linux startet; Linux bindet sich anschließend an den laufenden Kern an, ohne einen Reset auszulösen.
- Kommunikations- und Abstraktionsstack:
- Physikalische Schicht: Shared-Memory-Carveouts (Datenaustausch) + Mailbox/Interprozessor-Interrupts (Signalisierung/Doorbel-Signale).
- Konfigurations-/Vertragsschicht: Ressourcentabelle (vdev-Einträge), die zur Kompilierungszeit vom Remote-Kern statisch definiert wird, um den benötigten Speicher, die Puffer und die VirtIO-Kanäle festzulegen.
- Transportschicht: VirtIO unter Verwendung von zwei unidirektionalen V-Ringen (VirtQueues) zur Verwaltung gemeinsamer Pufferpools.
- Sitzungs-/Nachrichtenübermittlungsschicht: RPMsg (Remote Processor Messaging) für die Kanalankündigung, den Abgleich von Dienstnamen (z. B. rpmsg-tty) und die Instanziierung von Zeichen-Geräten.
- Wesentliche architektonische Einschränkung (Attach Model): Zephyr muss die Ressourcentabelle eigenständig in dediziertem gemeinsam genutztem RAM bereitstellen (nicht über eine ELF-Extraktion durch Linux), während die Linux-Device-Tree-Konfiguration sicherstellen muss, dass aktive Takte, Pins und Speicherbereiche während des Startvorgangs des primären Betriebssystems nicht neu initialisiert oder gesperrt werden.
- Zielhardware-Kontext: Heterogene SoCs (insbesondere Cortex-A53 + Cortex-M7, wie z. B. die Toradex Verdin SoM-Serie).
Dieser Beitrag ist eine (teil-)automatisierte Übersetzung des englischen Originals.
Moderne Anwendungsprozessoren werden zunehmend mit mehr als einer Art von CPU in einem Gehäuse ausgeliefert. Dies ermöglicht eine wesentlich direktere Integration eines funktionsreichen Mehrzweck-Betriebssystems zusammen mit einem Betriebssystem für Echtzeit- oder Sicherheitsanwendungen, verglichen mit dem, was mit separaten, dedizierten Mikroprozessoren oder Controllern möglich wäre.
Eine gängige Kombination besteht aus einem ARM Cortex-A-Anwendungsprozessor zusammen mit einem separaten Cortex-M-Echtzeitprozessor. Der erste der beiden läuft in der Regel unter Linux und übernimmt die Netzwerkfunktionen, rechenintensive Aufgaben oder eine Benutzeroberfläche, während der zweite ein Echtzeitbetriebssystem (RTOS) wie Zephyr ausführt und für Anwendungen mit Echtzeit- oder Sicherheitsanforderungen sowie für die Verwaltung von Low-Level-Peripheriegeräten zuständig ist.
Ein solches System erfordert eine sorgfältige, genau definierte Koordination zwischen den beteiligten Prozessoren, die auch als Lebenszyklusmanagement bezeichnet wird: Die Startreihenfolge der Prozessoren muss klar definiert sein, ebenso wie die Kommunikationskanäle und die verwendeten Protokolle zwischen ihnen sowie manchmal auch die Koordination der Abschaltsequenzen.
Im Linux-Kontext wird dies mithilfe des „remoteproc“-Frameworks erreicht. Nach dem Bootvorgang kann eine Linux-Userspace-Komponente dieses Framework nutzen, um den Echtzeitprozessor (auch als „Remote-Prozessor“ bezeichnet) zu steuern, eine Anwendung darauf zu laden und beim Aufbau der erforderlichen Kommunikationskanäle zu helfen. Der gesamte Prozess ist gut dokumentiert, und es stehen bereits zahlreiche Dokumentationen (remoteproc, rpmsg, virtio 1.3), Artikel und Konferenzvorträge zur Verfügung (ST Microelectronics: Überblick über das Linux-RPMsg-Framework, rt-rk: RPMsg-basierte Inter-Core-Kommunikation in heterogenen eingebetteten Systemen, Toradex: Verwendung von RemoteProc, Iuliana Prodan: „Enhancing OpenAMP: Making Linux and Zephyr Work Better Together“). Diese Lösung eignet sich jedoch nicht für Systeme, die einen sehr schnellen Start des Echtzeitprozessors erfordern. Selbst wenn das Linux-System für einen schnellen Start optimiert ist, beträgt die daraus resultierende Startverzögerung für den Echtzeitprozessor immer noch mehrere Sekunden. Das ist zu lang, wenn das Echtzeitsystem innerhalb von Millisekunden betriebsbereit sein muss.
Eine Lösung für dieses Problem besteht darin, den Echtzeitkern vor Linux zu starten und Linux anschließend daran anzuschließen. Dies lässt sich zwar durch geringfügige Änderungen an der Bootloader-Konfiguration leicht erreichen, die eigentliche Herausforderung liegt jedoch in der Anpassung des Lebenszyklusmanagements. Bei unveränderter Linux-seitiger Konfiguration geht Linux davon aus, die volle Kontrolle über den Lebenszyklus zu haben, und setzt den bereits laufenden Echtzeitprozessor zurück sowie konfiguriert ihn neu.
Die Frage lautet also: Wie können wir einen Startvorgang einrichten, bei dem Linux nicht seinem Standard-Lademodell folgt, sondern sich stattdessen an den bereits laufenden Prozessor anbindet? Und wie werden die Kommunikationskanäle hergestellt, wenn der Lebenszyklus nicht mehr ausschließlich von Linux verwaltet wird? Im Gegensatz zum gut dokumentierten Lademodell gibt es kaum bis gar keine Dokumentation darüber, wie das Anbindungsmodell implementiert werden kann.
Dieser Artikel ist in zwei Teile gegliedert: In diesem ersten Teil werden die grundlegenden Konzepte und der technische Hintergrund erläutert, während der zweite Teil, der in Kürze folgt, eine vollständige praktische Umsetzung Schritt für Schritt beschreibt.
Verfügbare Bausteine
Die Bausteine für den Aufbau einer Kommunikation zwischen zwei unabhängigen Prozessoren sind bereits verfügbar. In den folgenden Abschnitten werden sie ihrer jeweiligen Schicht im ISO/OSI-Schichtenmodell zugeordnet und ihre Rolle kurz beschrieben.
Gemeinsamer Speicher und Interprozessor-Interrupts
Die Kommunikation zwischen zwei unabhängigen Prozessoren erfordert einen Mechanismus zur Datenübertragung und eine Möglichkeit, sich gegenseitig Signale zu senden. Durch die korrekte Abfolge beider Schritte lässt sich eine robuste Interprozessorkommunikation realisieren.
Obwohl es auch andere Methoden gibt, ist der gemeinsame Speicher der gängigste Mechanismus für die Datenübertragung zwischen unabhängigen Kernen auf einem einzigen Chip. Beim gemeinsamen Speicher schreibt der sendende Prozessor Daten in einen Speicherbereich, auf den beide Prozessoren zugreifen können, und löst einen Interprozessor-Interrupt aus, um den empfangenden Prozessor zu benachrichtigen. Der empfangende Prozessor liest dann die Daten aus und sendet eine Bestätigung über den Abschluss des Vorgangs an den Absender zurück.
Die Einrichtung und Nutzung von gemeinsam genutztem Speicher für die Kommunikation zwischen Prozessoren bringt drei allgemeine Herausforderungen mit sich: Beide beteiligten Seiten müssen sich auf den konkreten Speicherort und die Größe des gemeinsam genutzten Speicherbereichs einigen, sie müssen möglicherweise die Cache-Kohärenz aufrechterhalten, und der Zugriff auf den gemeinsam genutzten Speicherbereich kann sich auf die Leistung auswirken. Darüber hinaus werden Interprozessor-Interrupts meist mit herstellerspezifischen Lösungen implementiert. In den meisten Fällen stellt eine dedizierte On-Chip-Peripherie die erforderliche Funktionalität bereit, benötigt jedoch in der Regel Treiberunterstützung durch beide beteiligten Betriebssysteme. Für diesen Teil der Artikelserie reicht es aus, zu wissen, dass diese Herausforderungen bestehen. Im zweiten Teil wird anhand eines konkreten Beispiels näher darauf eingegangen, wie sie gelöst werden.
Gemeinsamer Speicher und Interprozessor-Interrupts bilden zusammen die physikalische Schicht des ISO/OSI-Schichtenmodells.
Die Ressourcentabelle
Ein reservierter Bereich im gemeinsamen Speicher allein reicht nicht aus. Beide Seiten müssen sich zudem auf eine Definition der gemeinsamen Datenstruktur einigen, und es muss geklärt werden, welche Seite für deren Initialisierung verantwortlich ist. Dies ist die Aufgabe der Ressourcentabelle: Sie ist eine unterstützende Datenstruktur zum Aufbau von Kommunikationskanälen auf der Grundlage des gemeinsamen Speichers.
Das Format und der Zweck der Ressourcentabelle werden durch das „remoteproc“-Framework von Linux definiert. Sie wird vom Remote-Prozessor verwendet, um Linux mitzuteilen, was er für einen ordnungsgemäßen Betrieb benötigt. Dazu gehören die Anzahl und der Typ der Kommunikationskanäle für übergeordnete Protokolle sowie deren Konfigurations- und Statusinformationen.
Das „remoteproc“-Framework legt innerhalb der Ressourcentabelle vier Standard-Ressourcenkategorien fest. Zu diesen Kategorien gehören „carveout“, „devmem“, „trace“ und „vdev“. Von diesen spielt in dieser Artikelserie nur „vdev“ eine Rolle. Darüber hinaus führt die Bezeichnung „carveout“ zu einer semantischen Überschneidung: Einerseits beschreibt sie die statisch definierten Shared-Memory-Abschnitte, andererseits einen in „remoteproc“ und dessen Ressourcentabelle integrierten Ressourcentyp. Für proprietäre Anforderungen können Entwickler benutzerdefinierte Protokolle über einen festgelegten Bereich herstellerspezifischer Ressourcentypen implementieren.
Entscheidend ist, dass die Interaktion zwischen dem Remote- und dem Master-Prozessor als strikter Systemvertrag und nicht als aktiver Austausch während der Laufzeit implementiert ist. Der Remote-Prozessor definiert seine Anforderungen statisch zur Kompilierungszeit in der Ressourcentabelle, und der Master-Prozessor liest diese Anforderungen aus, um die Umgebung bereitzustellen. Wenn die Master-Seite die über die Tabelle angeforderten Ressourcen nicht bereitstellen kann, kann die Kommunikation nicht erfolgreich sein. Dieser Mechanismus ist unabhängig vom zugrunde liegenden Echtzeitbetriebssystem und funktioniert identisch, unabhängig davon, ob Zephyr, ein anderes RTOS oder eine Bare-Metal-Implementierung verwendet wird.
Wie beim Shared-Memory-Carveout muss der Speicherort für die Ressourcentabelle von beiden Prozessoren vereinbart werden. Bei Verwendung des Load-Modells wird die Ressourcentabelle in einem speziellen Abschnitt innerhalb des ELF-Images platziert, das die Anwendung für den Remote-Prozessor enthält. In diesem Fall extrahiert das „remoteproc“-Framework von Linux die Ressourcentabelle aus diesem ELF-Abschnitt und platziert sie an der richtigen Speicherposition, bevor die Anwendung auf dem Remote-Prozessor gestartet wird. Im Gegensatz dazu erfordert das „attach“-Modell, dass die Ressourcentabelle bereits vor dem Booten von Linux im Speicher abgelegt wird. Sie muss jedoch weiterhin von Linux initialisiert werden. Wie dies im Detail erreicht wird, wird im zweiten Teil dieses Artikels erläutert.
Die Ressourcentabelle lässt sich nicht einer bestimmten ISO/OSI-Schicht zuordnen: Sie enthält Konfigurationsinformationen, die für den gesamten Kommunikationsstack relevant sind.
VirtIO und VRings
Wie oben erwähnt, teilt die Ressourcentabelle der steuernden Seite mit, wie viele Kommunikationskanäle welcher Art sie erstellen soll, damit beide Seiten diese nutzen können. Obwohl benutzerdefinierte Transporte verwendet werden könnten, fordert die entfernte Seite in der Regel eine Kommunikation über Virtual I/O (kurz: virtio) unter Verwendung von zwei VRings an.
Die VirtIO-Spezifikation ist vor allem im Zusammenhang mit virtuellen Maschinen bekannt, doch ihre Konzepte gelten auch für Situationen, in denen zwei Prozessoren über gemeinsam genutzten Speicher miteinander kommunizieren. VirtIO unterscheidet zwei Arten von Kommunikationsteilnehmern: Geräte und Treiber. Hier stellt Linux die Treiberseite bereit, während der Remote-Prozessor als Gerät fungiert.
Virtio bietet eine Reihe vordefinierter Gerätetypen an. Jeder davon verfügt unter anderem über eine bekannte Geräte-ID, eine bestimmte Anzahl von V-Ringen für vordefinierte Zwecke und ein festgelegtes Laufzeitverhalten.
Mit Virtio tauschen Geräte und Treiber Massendaten mithilfe sogenannter V-Rings aus (in der Virtio-Spezifikation werden sie als „Virtqueues“ bezeichnet, unter Linux und Zephyr als „V-Ring“). Anstelle der eigentlichen Nutzdaten transportiert ein V-Ring Puffer-Deskriptoren und verwaltet Speicherbereiche, die aus einem gemeinsamen Pufferpool zugewiesen wurden. Ein bemerkenswertes Detail ist die Unidirektionalität eines V-Rings: Die Kommunikation vom Treiber zum Gerät erfolgt über einen anderen V-Ring als die Kommunikation in die andere Richtung.
Virtio und V-Ringe implementieren die Transportschicht des ISO/OSI-Schichtenmodells.
RPMsg
Aufbauend auf den von virtio implementierten Kommunikationsfunktionen gibt es rpmsg, auch bekannt als „Remote Processor Messaging“. Rpmsg ist ein Nachrichtenbus, der dazu dient, Kommunikationsendpunkte zu öffnen und Dienste namentlich anzukündigen. Rpmsg wird von virtio direkt als dedizierter, bekannter Gerätetyp unterstützt. Seine Spezifikation ist Teil der Linux-Kernel-Dokumentation.
Sobald ein entferntes virtio-Gerät einen rpmsg-Endpunkt erstellt, versucht der Linux-Kernel, einen rpmsg-Treiber zu finden, der dem angekündigten Kanalnamen entspricht. Bei Erfolg lädt Linux diesen Treiber und beginnt mit der Interaktion mit dem virtuellen Gerät. Wenn beispielsweise Zephyr auf der Remote-Seite einen Endpunkt mit dem Namen rpmsg-tty erstellt und Linux über einen passenden Rpmsg-Gerätetreiber verfügt, instanziiert Linux ein Gerät namens /dev/ttyRPMSG0. Dieses neue tty-Gerät implementiert die andere Seite der Verbindung. Verfügt Linux über keinen passenden Treiber, erkennt udev die Ankündigung zwar, es wird jedoch kein Treiber geladen.
Die Ankündigung eines neuen Dienstes ist auch von der Linux-Seite aus möglich. Analog zum obigen Beispiel könnte ein Linux-Treiber ebenfalls einen neuen Endpunkt deklarieren, und Zephyr könnte auf dieses Ereignis reagieren. In diesem Artikel liegt der Schwerpunkt auf Ankündigungen, die von Zephyr gemacht werden.
Vergleich zwischen Load- und Attach-Modell
Die oben genannten Bausteine sind alles, was zur Umsetzung beider Anwendungsfälle benötigt wird: sowohl des Load-Modells als auch des Attach-Modells. Da das oberste Ziel darin besteht, den Remote-Kern so früh wie möglich zu booten, lohnt es sich, einen Schritt zurückzutreten und den Boot-Ablauf beider Modelle zu veranschaulichen.
Abbildung 1 zeigt das gut dokumentierte Load-Modell. Nach dem Einschalten des Geräts beginnt der Bootloader auf dem Cortex-A53-Prozessor zu laufen. Der Bootloader lädt den Linux-Kernel in den Speicher und startet den Kernel. Nachdem der Linux-Kernel einen funktionsfähigen Userspace eingerichtet hat, kann ein Prozess das ELF-Image für den Remote-Cortex-M7-Kern ausfindig machen, laden und bereitstellen. Erst jetzt wird der M7-Kern freigegeben, startet Zephyr, und es kann ein Handshake zwischen beiden Prozessoren stattfinden.
Im Gegensatz dazu zeigt Abbildung 2 das „Attach“-Modell. Der Bootloader kümmert sich zunächst um das Laden und Starten der Anwendung für den entfernten Prozessor, und erst danach wird der Linux-Kernel gestartet. Der M7-Kern beginnt mit der Ausführung, noch bevor der Linux-Kernel in den Speicher geladen wird. Er kann kritische Geschäftslogik ausführen, während er im Hintergrund darauf wartet, dass Linux bereit ist – genau das, was für ein Szenario mit frühem Systemstart erforderlich ist.
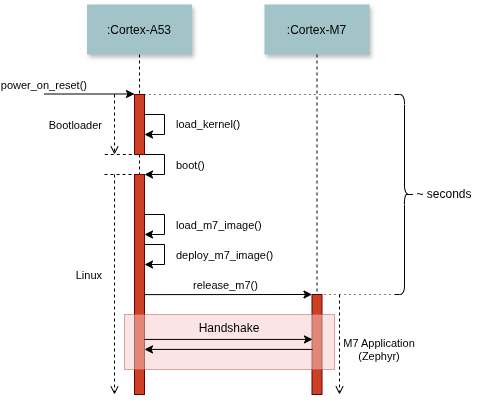
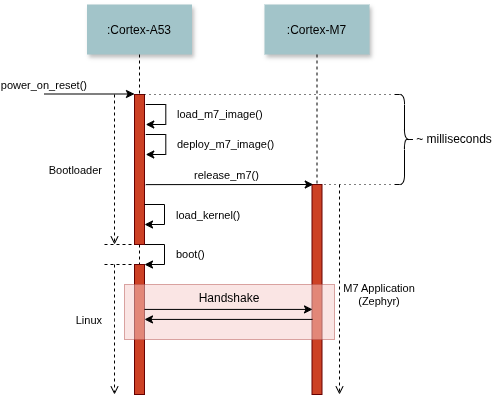
Die beiden Abbildungen verdeutlichen die Unterschiede hinsichtlich der Reihenfolge und des Zeitablaufs zwischen dem „Load“- und dem „Attach“-Modell. Im „Load“-Modell findet fast der gesamte Linux-Bootvorgang zwischen dem Power-On-Reset und der Freigabe des M7-Prozessors statt. Der Bootloader muss ein mehrere Megabyte großes Kernel-Image aus dem Speicher laden und möglicherweise dessen Integrität überprüfen. Der Kernel startet dann, initialisiert seine Speicherverwaltung, sucht nach Treibern, aktiviert Geräte und hängt das Root-Dateisystem ein. Erst nachdem diese Schritte abgeschlossen sind, kann das Init-System einen Dienst starten, um das Image für den M7-Prozessor zu laden. Folglich benötigt selbst ein hochoptimiertes System für diesen Ablauf einige Sekunden.
Im Gegensatz dazu erfordert das „Attach“-Modell lediglich den Bootloader als Voraussetzung. Er kopiert ein Anwendungsimage von einigen hundert Kilobyte in den Speicher und gibt den M7-Prozessor sofort frei. Einschließlich einer möglichen Integritätsprüfung des M7-Images ist diese Abfolge innerhalb weniger Millisekunden nach dem Power-On-Reset abgeschlossen. Letztendlich wird der gesamte Linux-Bootvorgang aus dem kritischen Pfad der Echtzeitanwendung herausgenommen.
Beide Diagramme zeigen zudem einen anfänglichen Handshake zwischen den beiden beteiligten Prozessoren. Ohne hier zu sehr ins Detail zu gehen – der Folgeartikel wird auf die Einzelheiten eingehen –, umfasst dieser Handshake stets dieselben grundlegenden Schritte:
- Linux liest die Ressourcentabelle und identifiziert einen vdev-Eintrag, der ein rpmsg-Gerät mit zwei vRings anfordert.
- Linux initialisiert die vRings und den Pufferpool innerhalb des für den gemeinsamen Speicher reservierten Bereichs.
- Linux signalisiert die Bereitschaft, indem es ein Statusflag im vdev-Eintrag setzt und anschließend Zephyr auf dem M7-Prozessor benachrichtigt.
- Zephyr erkennt die Änderung des Statusflags, initialisiert sein Ende der vrings und gibt seine rpmsg-Endpunkte über deren Dienstnamen bekannt.
- Linux gleicht jeden bekannt gegebenen Dienstnamen mit seinen rpmsg-Treibern ab und instanziiert die entsprechenden Geräte.
Bei Anwendung des Lastmodells analysiert „remoteproc“ von Linux die Ressourcentabelle, bevor der Speicher belegt und der M7-Kern freigegeben wird, sodass für Zephyr in Schritt 3 nur eine minimale oder gar keine anfängliche Wartezeit entsteht. Im Gegensatz dazu ermöglicht das „Attach“-Modell, dass Zephyr vor Linux startet. Zwar muss Zephyr in Schritt 3 für eine unbekannte Zeit auf Linux warten, bis die Initialisierung abgeschlossen ist, doch kann es sofort kritische Anwendungsaufgaben ausführen, während der Kommunikationskanal zur Linux-Seite in einer Hintergrundaufgabe aufgebaut wird. Dies ist jedoch nur möglich, wenn Zephyr die Ressourcentabelle selbstständig in den Speicher laden kann: Die Ressourcentabelle darf nicht mehr Teil des ELF-Images sein. Schließlich dürfen alle von Zephyr verwendeten Takte, Pins und Peripheriegeräte von Linux unberührt bleiben, da Linux diese andernfalls während des Bootvorgangs deaktivieren könnte.
Fazit
Damit ist der einführende Teil dieser Artikelserie abgeschlossen, in dem die Grundlagen einer „remoteproc“-Konfiguration mit rpmsg-basierter Kommunikation zwischen den Prozessoren behandelt wurden. Ein früher Start des Echtzeitprozessors erfordert ein anderes Initialisierungsmodell als die herkömmliche Bereitstellung, die auf dem „Load“-Modell basiert. Stattdessen nutzen zeitkritische Anwendungen das „Attach“-Modell und starten den Echtzeitkern frühzeitig. Um eine robuste Kommunikation zwischen den Prozessoren herzustellen, nutzen beide Paradigmen dieselben Bausteine: Hardware-Interrupts, Shared-Memory-Carveouts, eine gemeinsame Ressourcentabelle, virtio auf der Transportschicht und rpmsg-Endpunkte. Der zweite Teil dieser Artikelserie behandelt die technischen Details der beteiligten Bausteine und erläutert die notwendigen Schritte zur Implementierung des „Attach“-Modells auf einem Toradex Verdin SoM.
Stay tuned!