TL;DR:
Die Installation von Databricks Connect beeinträchtigt die üblichen lokalen Tests, da sie die native PySpark-Bibliothek – die dafür ausgelegt ist, Spark-Sitzungen direkt auf Ihrem Rechner auszuführen – durch eine spezielle Version ersetzt, die ausschließlich für die Remote-Verbindung konzipiert ist. Diese Inkompatibilität macht herkömmliche lokale Spark-Unit-Tests innerhalb derselben Umgebung unmöglich. Um eine funktionsfähige Testsuite aufrechtzuerhalten, müssen Sie Ihre Entwicklungsarchitektur von der lokalen Spark-Ausführung auf ein Remote-Sitzungsmodell umstellen, beispielsweise durch das Hosten eines lokalen Spark-Master-Servers über Container.
Dieser Beitrag ist eine (teil-)automatisierte Übersetzung des englischen Originals.
Tests sind ein Eckpfeiler jeder produktionsreifen Anwendung und erhöhen die Zuverlässigkeit sowohl bei der lokalen Entwicklung als auch in den Pipelines. Doch die Umstellung auf Cloud-native Ökosysteme wie Databricks kann zu unerwarteten Schwierigkeiten führen. Eine solche Schwierigkeit haben wir bei der Verwendung der Databricks-eigenen Client-Bibliothek „Databricks Connect“ festgestellt.
Warum? Die Integration der Bibliothek kann lokale Test-Workflows unterbrechen.
Bei der Real I.S. AG entwickeln wir eine Datenintegrationsplattform auf Basis von Databricks. Als Teil unseres Toolkits nutzen wir Databricks Connect. Wir haben jedoch festgestellt, dass dieses spezielle Paket eine besondere Handhabung bei der Ausführung von Tests erfordert.
Dieser Beitrag beleuchtet die technischen Feinheiten dieses Fehlers, bietet einen detaillierten Einblick in die Funktionsweise von Databricks Connect und skizziert unsere Lösung zur Aufrechterhaltung einer nahtlosen, funktionsfähigen Testumgebung.
Databricks Connect als Bindeglied zwischen Ihnen und Databricks
Apache Spark ist eine der führenden Engines für verteilte Verarbeitung und Analyse und wird in einer Vielzahl unserer Projekte eingesetzt. Das PySpark-Paket bezeichnet die standardmäßige, native Methode zur Interaktion mit Spark unter Verwendung von Python. Im Hintergrund installiert es in seinem Paket Java-Abhängigkeiten, um lokale SparkSessions direkt auf Ihrem Entwicklungsrechner zu erstellen. Dieser Ansatz ist für die lokale Entwicklung und das Testen sehr leistungsfähig, da er es Ihnen ermöglicht, Spark-Berechnungen auszuführen, ohne eine Verbindung zu einem Remote-Cluster herstellen zu müssen:
|
1 2 3 4 5 6 7 |
from pyspark.sql import SparkSession spark = SparkSession.builder.getOrCreate() df = spark.createDataFrame( [(1, "foo"),(2, "bar"),], ["id", "label"] ) |
In einer modernen Databricks-Umgebung kommt häufig die Client-Bibliothek „Databricks Connect“ zum Einsatz. Dieses Paket ermöglicht die Integration verschiedener IDEs wie PyCharm oder VSCode. Dadurch stehen Funktionen wie der Zugriff auf Databricks-Rechenressourcen, Debugging-Funktionen und vieles mehr zur Verfügung. Connect lässt sich wie gewohnt als Paket installieren:
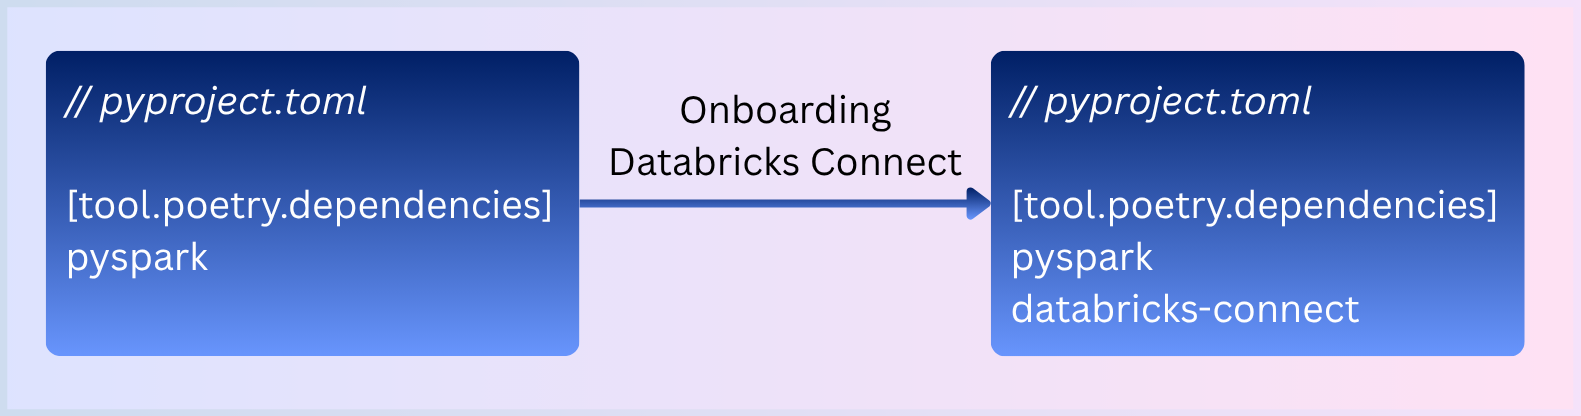
Der Versuch, den nativen PySpark-Ansatz (Erstellung einer lokalen SparkSession) in einer für Databricks Connect konfigurierten Umgebung zu verwenden, führt zu einem RuntimeError, da Databricks Connect ausschließlich Remote-Sitzungen unterstützt:
|
1 2 3 4 |
from pyspark.sql import SparkSession spark = SparkSession.builder.getOrCreate() # RuntimeError: Only remote Spark sessions using Databricks Connect are supported. Use DatabricksSession.builder to create a remote Spark session instead. |
Der Grund dafür: Databricks Connect ersetzt Ihr bestehendes PySpark-Paket durch eine speziell für Databricks entwickelte Version. Diese ist ausschließlich für Remote-Sitzungen ausgelegt, sodass die Möglichkeit, lokale Sitzungen zu hosten, entfällt.
- Ein genauerer Blick auf das Connect-Paket verdeutlicht dieses Verhalten. Es werden ausschließlich Remote-Konfigurationseinstellungen ausgewertet. Fehlen diese, wird standardmäßig der oben genannte RuntimeError ausgelöst.
Anstatt Spark lokal auszuführen, muss eine Verbindung von Ihrer IDE zu einem Remote-Spark-Cluster hergestellt werden, z. B. zu einem auf Databricks gehosteten Hochleistungscluster.
- Der besseren Lesbarkeit halber fahren wir mit einer Konfiguration fort, die lokal mit Remote-Sitzungen arbeitet. Wenn Sie an den Details interessiert sind, wie und warum Databricks Connect bestimmte Pakete wie PySpark ersetzt, springen Sie zum Abschnitt „Ein Einblick in Databricks Connect“ weiter unten.
Um eine Verbindung zu einem Spark-Server herzustellen, können Sie weiterhin den Remote-Session-Builder aus dem ersetzten PySpark-Paket verwenden:
|
1 2 3 4 |
from pyspark.sql import SparkSession # Remote session via Spark Connect (sc) spark = SparkSession.builder.remote("sc:// |
Für die Durchführung lokaler Tests bedeutet dies, dass Sie einen Spark-Server bereitstellen müssen. Container vereinfachen dies erheblich.
Devcontainers als Lösung
Devcontainers bieten einen modernen Ansatz, um die Entwicklungsumgebung reproduzierbar und konsistent zu halten. Ein typischer Ansatz ist ein einzelner Container, der die Laufzeitumgebung und die Bibliotheken des Produktionssystems widerspiegelt.
Die Anforderung einer Remote-SparkSession lässt sich durch die Einführung eines zweiten Devcontainers lösen: eines Open-Source-Spark-Servers, der als Docker-Image bereitgestellt wird.
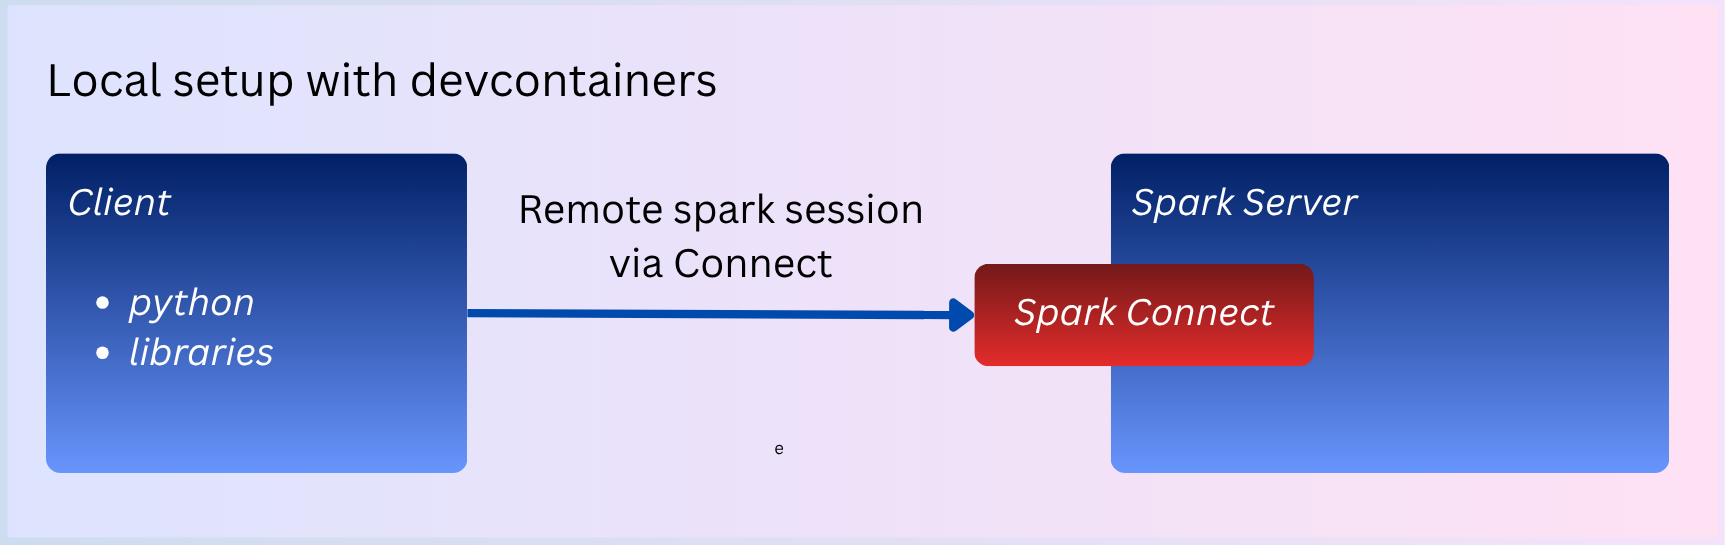
Nachdem der SparkSession Builder so konfiguriert wurde, dass er auf den Container verweist, kann schließlich mithilfe von Spark Connect eine Remote-SparkSession hergestellt werden.
|
1 2 3 4 |
from pyspark.sql import SparkSession # Reference the name of the spark container spark = SparkSession.builder.remote("sc://spark").getOrCreate() |
Einbindung von pytest
Ein parametrisierter Test, der ein agnostisches Spark als Fixture verwendet, könnte wie folgt aussehen:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 |
# tests/test_spark.py from collections import namedtuple import pytest Metadata = namedtuple("Metadata", ["description"]) PySparkTestParameter = namedtuple( "PySparkTestParameter", ["metadata", "data", "schema", "expected_count"] ) @pytest.mark.parametrize( "params", [ PySparkTestParameter( metadata=Metadata("simple"), data=[ (1, "foo"), (2, "bar"), ], schema=["id", "label"], expected_count=2, ) ], # more verbose logs ids=lambda p: p.metadata.description, ) def test_pyspark(spark, params): df = spark.createDataFrame( data=params.data, schema=params.schema, ) df.show() assert df.count() == params.expected_count |
Bei Verwendung der Multi-Devcontainer-Konfiguration lässt sich die Testumgebung wie folgt aufbauen:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 |
# tests/conftest.py import pytest from pyspark.sql import SparkSession @pytest.fixture(scope="session") def spark() -> SparkSession: _spark = SparkSession.builder.remote("sc://spark").getOrCreate() # add missing configurations _spark.conf.set("spark.sql.pyspark.legacy.inferMapTypeFromFirstPair.enabled", True) _spark.conf.set("spark.sql.execution.pandas.inferPandasDictAsMap", False) return _spark |
Wenn ich pytest jetzt ausführe, erhalte ich die gewünschte Ausgabe: Eine lokal ausgeführte SparkSession unter Verwendung von Databricks Connect!
|
1 2 3 4 5 6 7 8 9 10 |
((python_venv) ) vscode ➜ /workspace (master) $ pytest -v ==================================================================== test session starts ===================================================================== platform linux -- Python 3.12.12, pytest-9.0.2, pluggy-1.6.0 -- /python_venv/bin/python cachedir: .pytest_cache rootdir: /workspace configfile: pyproject.toml plugins: anyio-4.12.1 collected 1 item tests/test_spark.py::test_pyspark[simple] PASSED |
Ein Einblick in das Python-Paket von Databricks Connect
TL;DR: Databricks Connect ersetzt Ihr natives PySpark-Paket durch eine speziell für die Databricks-Plattform entwickelte Version, die keine lokale SparkSession hosten kann. Beide Pakete schließen sich gegenseitig aus.
Werfen wir einen Blick auf das Paket von Databricks Connect selbst:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 |
> pip download databricks-connect -d download --no-dependencies > cd download > unzip databricks_connect-*.whl > tree -L 2 . . ├── databricks │ ├── __init__.py │ └── connect ├── databricks_connect-16.1.7-py2.py3-none-any.whl ├── databricks_connect-16.1.7.data │ └── scripts ├── databricks_connect-16.1.7.dist-info │ ├── entry_points.txt │ ├── METADATA │ ├── RECORD │ ├── top_level.txt │ └── WHEEL ├── delta │ ├── __init__.py │ └── ... └── pyspark ├── __init__.py ├── ... ├── sql.py ├── session.py └── ... |
Neben „databricks.connect“ selbst sind zwei weitere Pakete enthalten: „delta“ und „pyspark“. Bei näherer Untersuchung des Wheel-Ordners databricks_connect-16.1.7.dist-info (weitere Informationen finden Sie unter https://packaging.python.org/en/latest/specifications/binary-distribution-format/#binary-distribution-format) stellen wir fest, dass Databricks Connect Vorrang vor zuvor installierten delta-/pyspark-Paketen hat und diese ersetzt.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 |
> cat databricks_connect-16.1.7.dist-info/top_level.txt databricks delta pyspark > cat databricks_connect-16.1.7.dist-info/METADATA ... Provides: pyspark Obsoletes: pyspark ... > du -s -m pyspark 11 pyspark # 11 Megabyte. Much less than native PySpark as Java dependencies are missing (required for local session) |
Minimales Funktionsbeispiel
Klonen Sie das Beispiel und führen Sie es selbst in der IDE Ihrer Wahl aus: https://github.com/inovex/databricks-pyspark-local-testing-demo
Zusammenfassung
Databricks Connect verhindert, dass Sie mit dem PySpark-Paket einen lokalen Spark-Server erstellen können. Sie können jedoch weiterhin Remote-Sitzungen erstellen, die auf Databricks gehostet werden oder Ihnen anderweitig zur Verfügung stehen (z. B. ein lokal ausgeführter Spark-Server). Mithilfe von DevContainern können Sie sowohl Ihre Entwicklungsumgebung als auch einen Spark-Server auf entwicklerfreundliche Weise hosten. Und Sie können Ihre Tests weiterhin wie gewohnt ausführen.
Der Nachteil dieses Ansatzes ist ein im Vergleich zum Databricks-Ökosystem eingeschränkter Funktionsumfang. Einige Funktionen funktionieren möglicherweise nicht für Ihren individuellen Anwendungsfall: Der Spark Connect-Server (und damit die Remote-Sitzung) bietet nur einen begrenzten Teil der Funktionen des gesamten Databricks-Ökosystems. Funktionen, die auf einer tiefgreifenden Integration mit Databricks-spezifischen Diensten beruhen – wie spezielle Datentypen oder andere proprietäre Dienstprogramme –, sind in dieser eigenständigen Umgebung möglicherweise nicht vollständig verfügbar. Entwickler müssen sicherstellen, dass dieser Ansatz alle wesentlichen Funktionen abdeckt, die für ihren individuellen Anwendungsfall erforderlich sind.